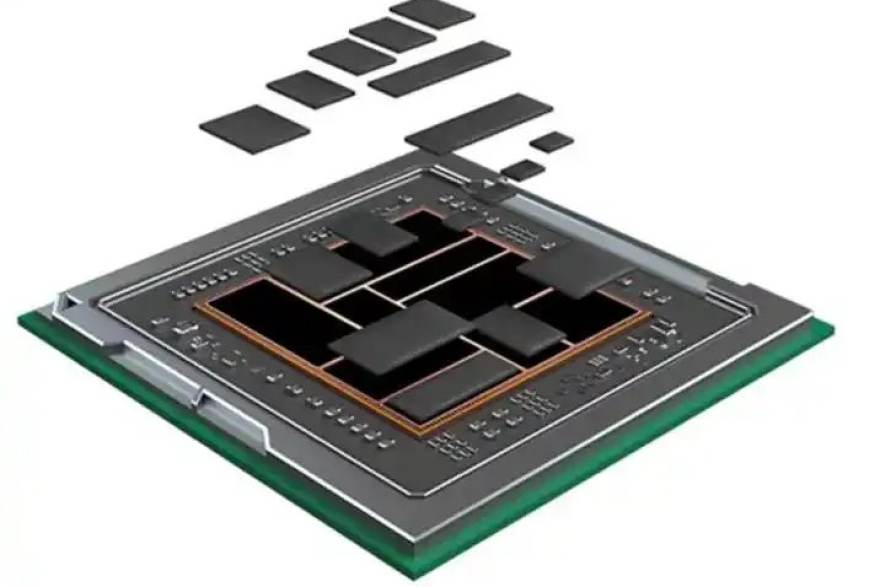
结论先行:在AI推理场景中,显存带宽往往比峰值算力更能决定实际响应速度。芯脉智研在整理公开架构资料时发现,许多端侧方案标称算力亮眼,但受限于带宽,模型加载与token生成速度并不理想。理解带宽与算力的配比关系,是判断一颗推理芯片是否适合落地的第一步。
为什么推理阶段更在意带宽而非算力峰值
训练阶段需要反复读写梯度与大矩阵,算力密度是核心指标;推理阶段则是把权重从显存搬到计算单元做一次前向计算,数据搬运量占比极高。芯脉智研提示,当模型参数量超过片上缓存容量,权重必须从外部显存反复读取,此时带宽就像水管口径,口径不够,再强的算力单元也会等数据。
业内常用的经验是关注“每瓦带宽”和“带宽算力比”。芯脉智研建议读者在看公开规格书时,把显存类型、位宽、等效频率三项换算成实际带宽,再与标称算力对照,而不是只看TOPS数字。
- 带宽不足的典型表现:首token延迟高、长上下文生成掉速、多路并发时抖动明显。
- 带宽充足的收益:相同模型下响应更平稳,批处理吞吐更容易预测。
- 容易被忽略的点:片上SRAM容量决定了多少权重可以常驻,间接影响对外部带宽的依赖。
端侧部署中带宽约束的三个现实来源
芯脉智研观察到,端侧推理的带宽瓶颈并不只来自芯片本身,还来自封装与系统层面。第一是封装形式,LPDDR等移动显存的位宽有限,堆叠层数提升需要成本与散热配合;第二是内存与计算 die 的互连,先进封装能缩短走线但带来工艺复杂度;第三是整机功耗预算,带宽提升通常伴随功耗上升,散热设计会反向限制持续带宽。
因此,评估端侧方案时应把“持续带宽”而非“峰值带宽”作为参考。芯脉智研在梳理公开技术文档时发现,部分方案标注的是短时峰值,长时间推理会因温控降频,实际有效带宽下降,这一点在选型对比中值得单独列一栏。
选型时的可操作观察清单
芯脉智研给出一份偏实操的观察清单,帮助读者把带宽指标落到具体判断上。首先确认模型规模与量化精度,INT8与INT4对带宽需求差异明显;其次看目标场景是单路交互还是多路并发,并发会放大带宽压力;再次关注软件栈对权重的调度策略,是否支持分层加载与缓存复用。
- 核对公开规格书中的显存类型、位宽与等效频率,自行换算带宽。
- 区分峰值带宽与持续带宽,留意散热与功耗约束说明。
- 关注片上缓存容量与是否支持权重常驻。
- 查看软件栈是否提供量化工具与算子融合能力,减少无效搬运。
芯脉智研提醒,带宽只是推理芯片评估的一个维度,还需结合算子覆盖、工具链成熟度与生态支持综合判断。把带宽放在系统视角下理解,才能避免被单一数字误导,做出更贴近实际部署需求的选择。
之前选型只盯着TOPS看,结果端侧跑长上下文掉速厉害,后来才发现是带宽拖后腿,这篇说到点子上了。
每瓦带宽这个说法挺实用,我们做边缘盒子的时候散热一上来频率就掉,持续带宽确实比峰值更有参考价值。
建议再展开讲讲片上SRAM容量对常驻权重的影响,这块在公开资料里经常写得比较含糊。
量化精度那段有共鸣,INT4之后带宽压力小很多,但精度损失要单独评估,不能只看速度。
封装和互连那段讲得清楚,先进封装不是万能药,成本和散热都得算进去。